~/教學/ANYDOC.md
AnyDoc:PPT、Excel、Word 一行指令變成 Markdown,Claude Code 終於讀得懂(實測三份檔案)
Firecrawl 開源的 AnyDoc 把 Word、PPT、Excel、PDF、EPUB 轉成乾淨的 Markdown。一行 npx、裝成 Claude Code 技能、轉出來長什麼樣,還有掃描 PDF 的 OCR 限制。
丟一份 PPT 或 Excel 給 Claude Code,它沒辦法直接讀,得先另外寫程式拆檔。Firecrawl 開源的 AnyDoc 一行指令,就把 Word、PPT、Excel、PDF、EPUB 變成乾淨的 Markdown,表格、圖表數字和講者備註都留著。這篇是 Reels 裡 ANYDOC 那支影片的完整版:我拿三份檔案實際轉過,從為什麼要轉、怎麼轉、轉出來長什麼樣,到裝成技能讓 Claude Code 自己轉,還有掃描 PDF 的限制。
01先看結果:同一份簡報,變成 Claude 一眼讀懂的 Markdown
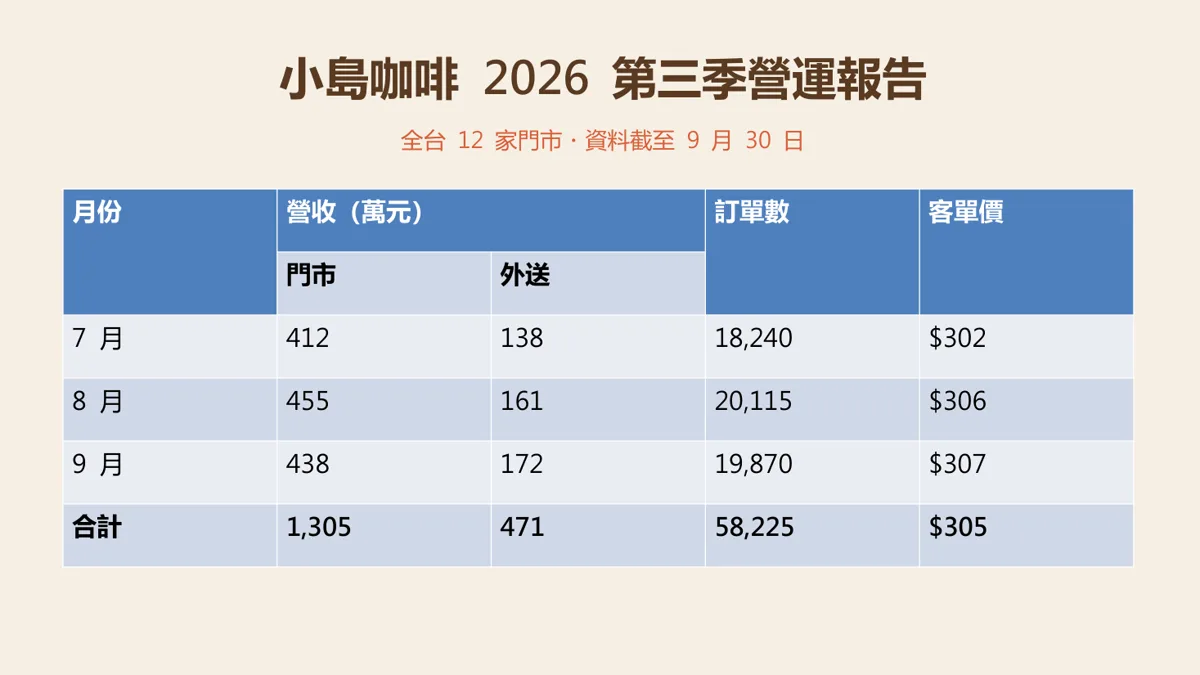
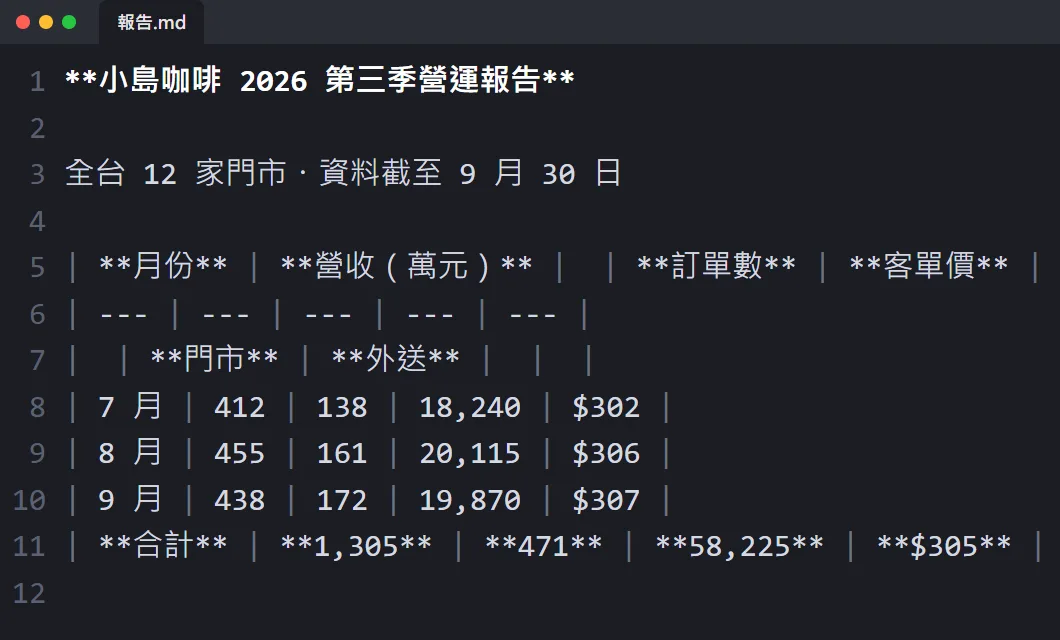
照著做完,你會有:
- 一份 .md 檔:標題、表格、條列、講者備註都照原本的結構排好。
- 一個 Claude Code 技能:之後遇到 Word、PPT、Excel,它會自己先轉再讀。
- 一個判斷:哪些檔案能在本機轉,哪些(掃描的 PDF)會上傳到雲端。
02為什麼 Claude Code 讀不了 PPT 和 Excel
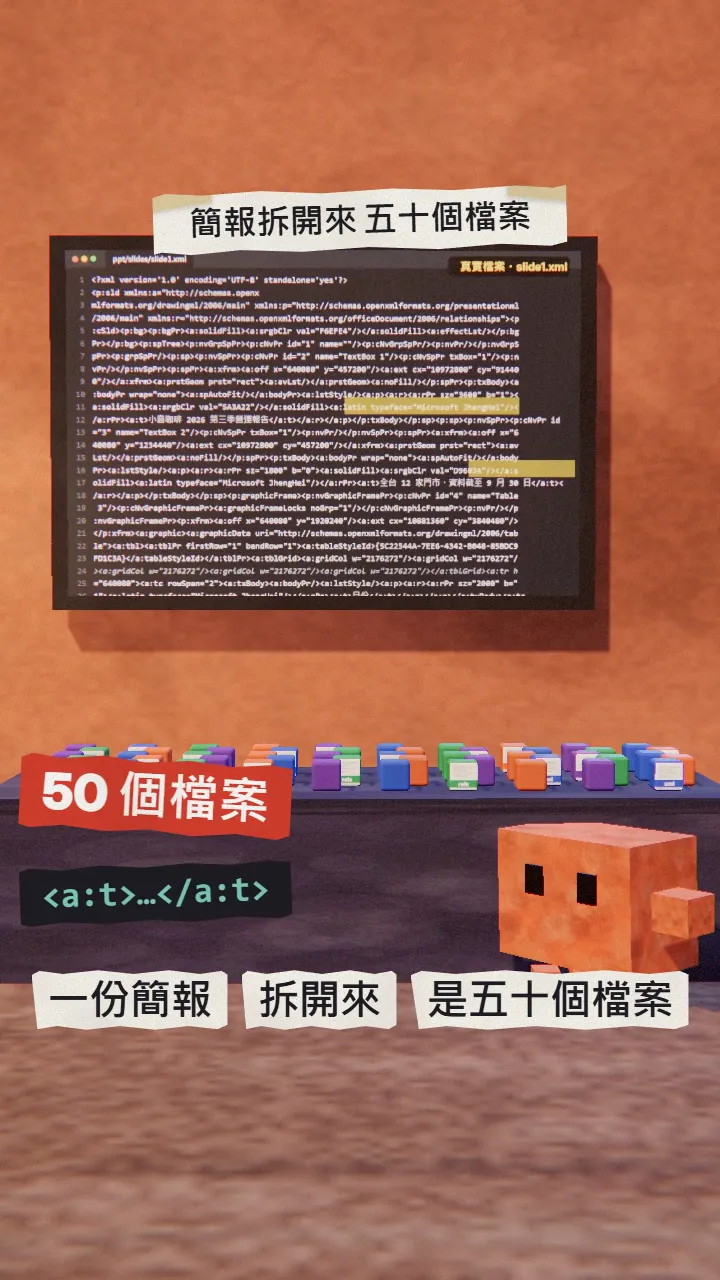
Claude Code 讀檔案的工具會拒絕它當成二進位的檔案,例如 .xlsx,這時它只能另外寫程式或找技能來拆。原因是 .pptx、.docx、.xlsx 其實是壓縮檔,開啟來是一堆 XML。
- 我們這份只有兩頁的簡報,拆開來有 50 個檔案。
- 光是第 1 頁的 slide1.xml,就有 7,308 個字元,大部分是排版標籤。
- 整份簡報轉成 Markdown 之後,只剩 969 bytes。
03第 1 步:一行指令轉檔
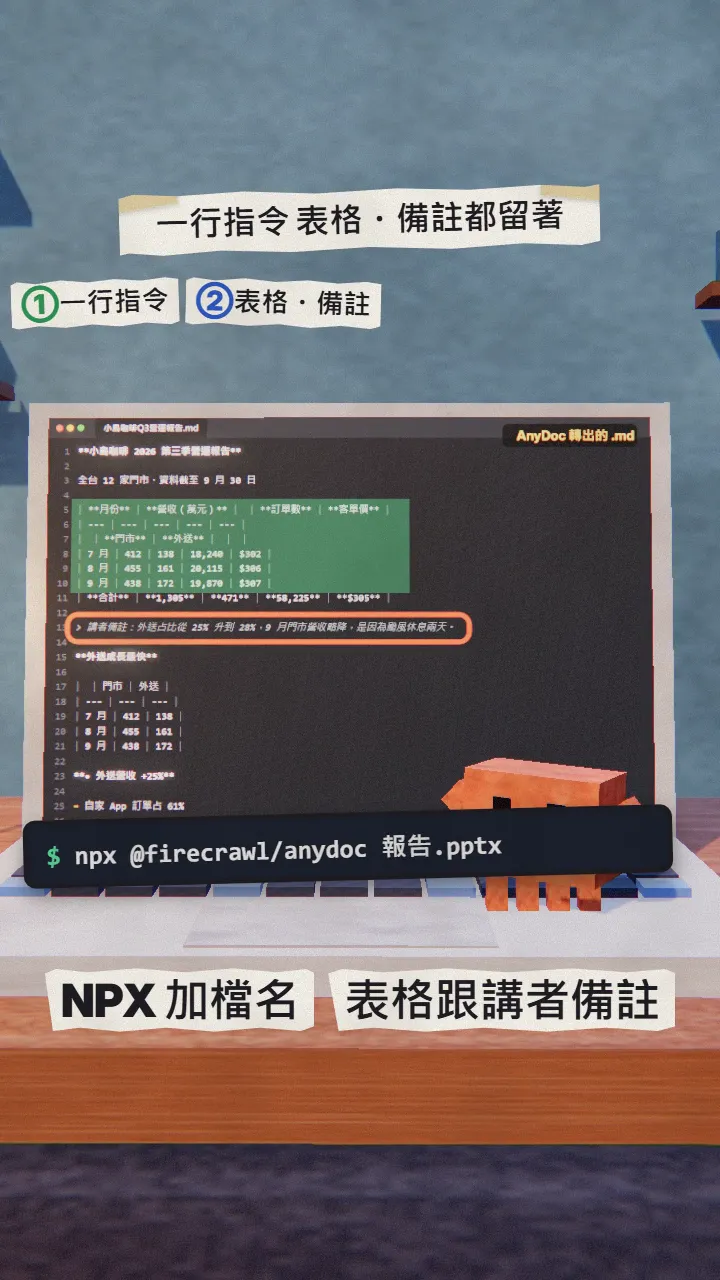
電腦有 Node.js 就能直接用,第一次執行會自動下載對應你電腦的版本:
npx @firecrawl/anydoc [報告.pptx] -o [報告.md]
常用的話,裝成固定指令:
npm install -g @firecrawl/anydoc
anydoc [報告.docx] -o [報告.md]
pip install firecrawl-anydoc
04第 2 步:看看轉出來長什麼樣
我們三份檔案實際轉出來的樣子:
- 簡報的表格變成 Markdown 表格;合併的表頭變成一格空白,數字都對。
- 長條圖的數字變成一張表格,Claude 讀得到 7、8、9 月的數字。
- 講者備註變成「>」開頭的引用,跟在那一頁後面。
- 條列保留了層級;Excel 的公式總計(377、354、731)也有出來。
- Word 合約的標題、表格和 1. 2. 3. 編號都照原本排好。
05第 3 步:裝成技能,讓 Claude Code 自己轉
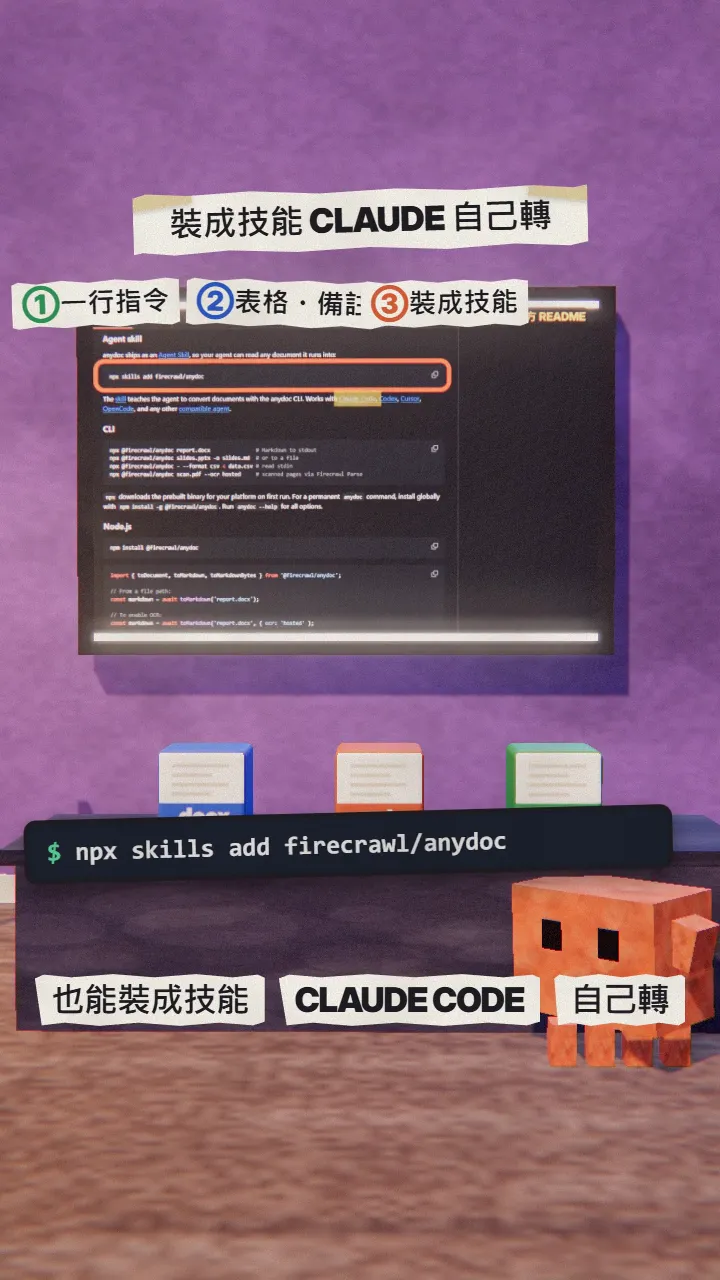
不想每次自己轉,就把它裝成技能。在專案的終端機執行:
npx skills add firecrawl/anydoc
之後直接把檔案丟給 Claude Code:
幫我讀[報告.pptx],整理成三個重點,再把表格裡的數字做成一張比較表。
06要注意
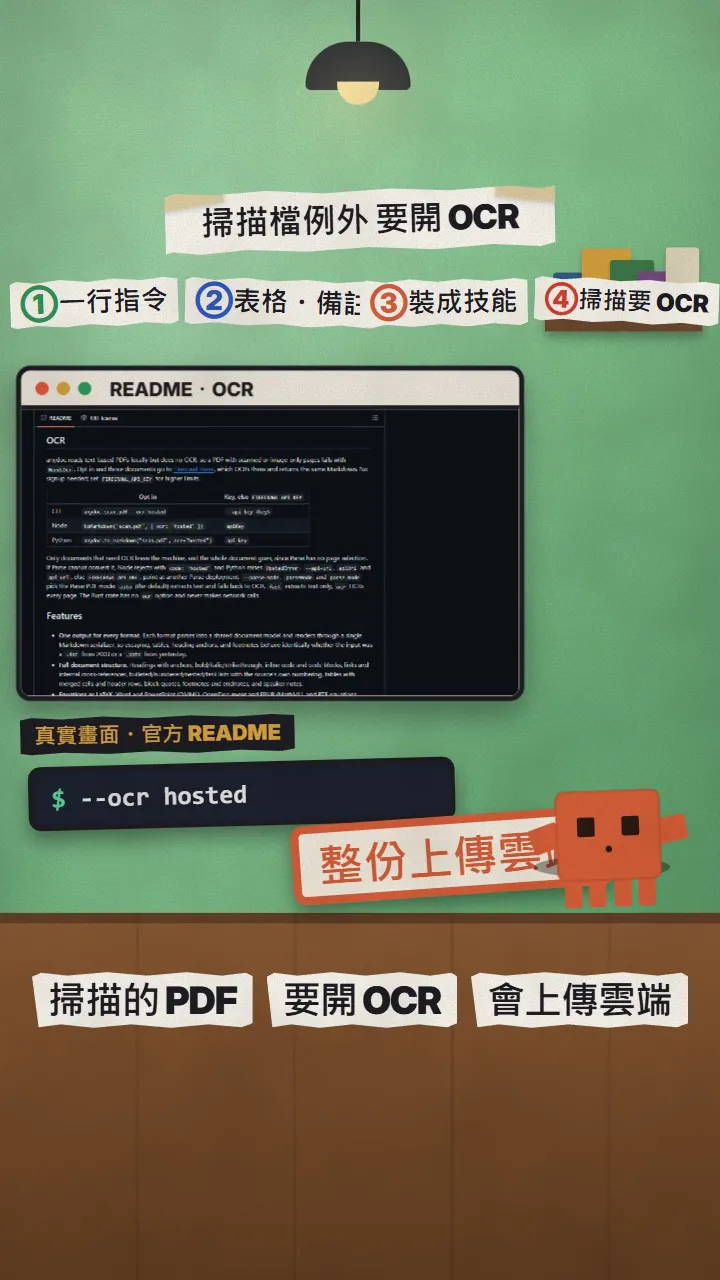
- 掃描或純圖片的 PDF 它讀不到(會直接停下來)。加 --ocr hosted 才會送到 Firecrawl Parse 做 OCR,而且是整份檔案上傳;不用註冊,設 FIRECRAWL_API_KEY 額度比較高。機密檔案先想清楚。
- 不想裝任何東西:官方的瀏覽器版 firecrawl.github.io/anydoc 在你的電腦上轉,檔案不會上傳。
- 圖片只會留下替代文字,圖片本身不會放進 Markdown。
- README 裡和其他工具的比較分數是 Firecrawl 自己測的,參考就好。
- AnyDoc 是 MIT 授權的開源專案,不是 Anthropic 官方出的。
- 這篇是在主頁連結輸入關鍵字 ANYDOC 找到的,不會私訊。
資料來源
下一支 Reel 想學什麼?
我每天測 Claude 和 AI 工具,把真的有用的做成 Reel。追蹤 @vivianlin.tech,新教學一出來就看得到。


