~/教學/SAVE.md
Headroom:讓 Claude Code 用更少 token 做同樣的事,額度撐更久
Headroom 是免費開源的工具,夾在 Claude Code 和模型中間,先把 log、搜尋結果這些輸出壓縮再送出去。附安裝、headroom wrap claude 用法、怎麼看省多少和什麼時候省不到。
Claude Code 的額度常常不是被你的問題吃掉,而是被它讀進去的東西吃掉:一大段 log、幾百筆搜尋結果、整包 JSON。Headroom 是一個免費開源(Apache 2.0)的工具,夾在 Claude Code 和模型中間,先把這些工具輸出壓縮,重要的留著,再送出去。這篇是 Reels 裡 SAVE 那支影片的完整版:我們在自己電腦上跑出來的真實數字、安裝指令、怎麼用 headroom wrap claude 接上 Claude Code、怎麼看省了多少,以及它省不到的情況。
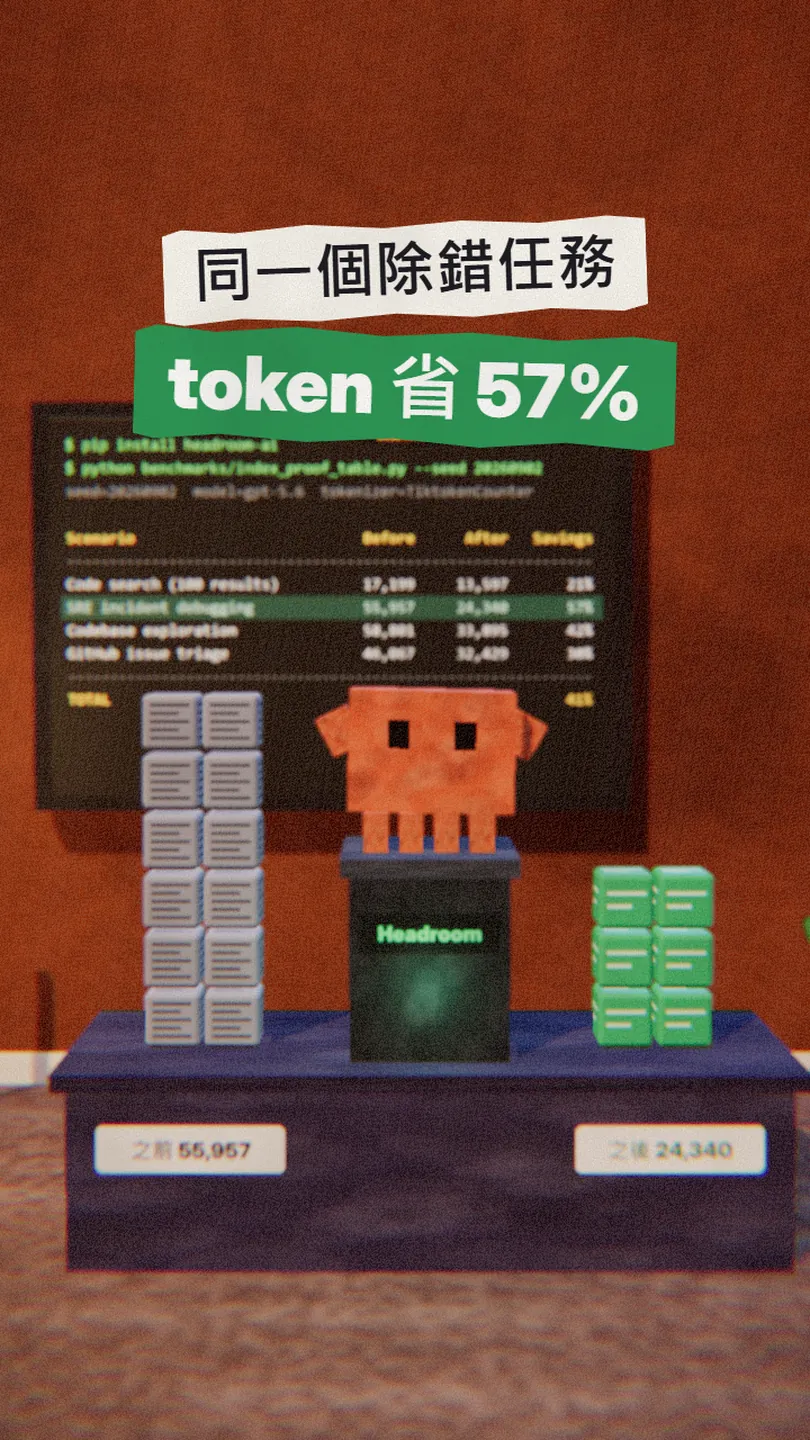
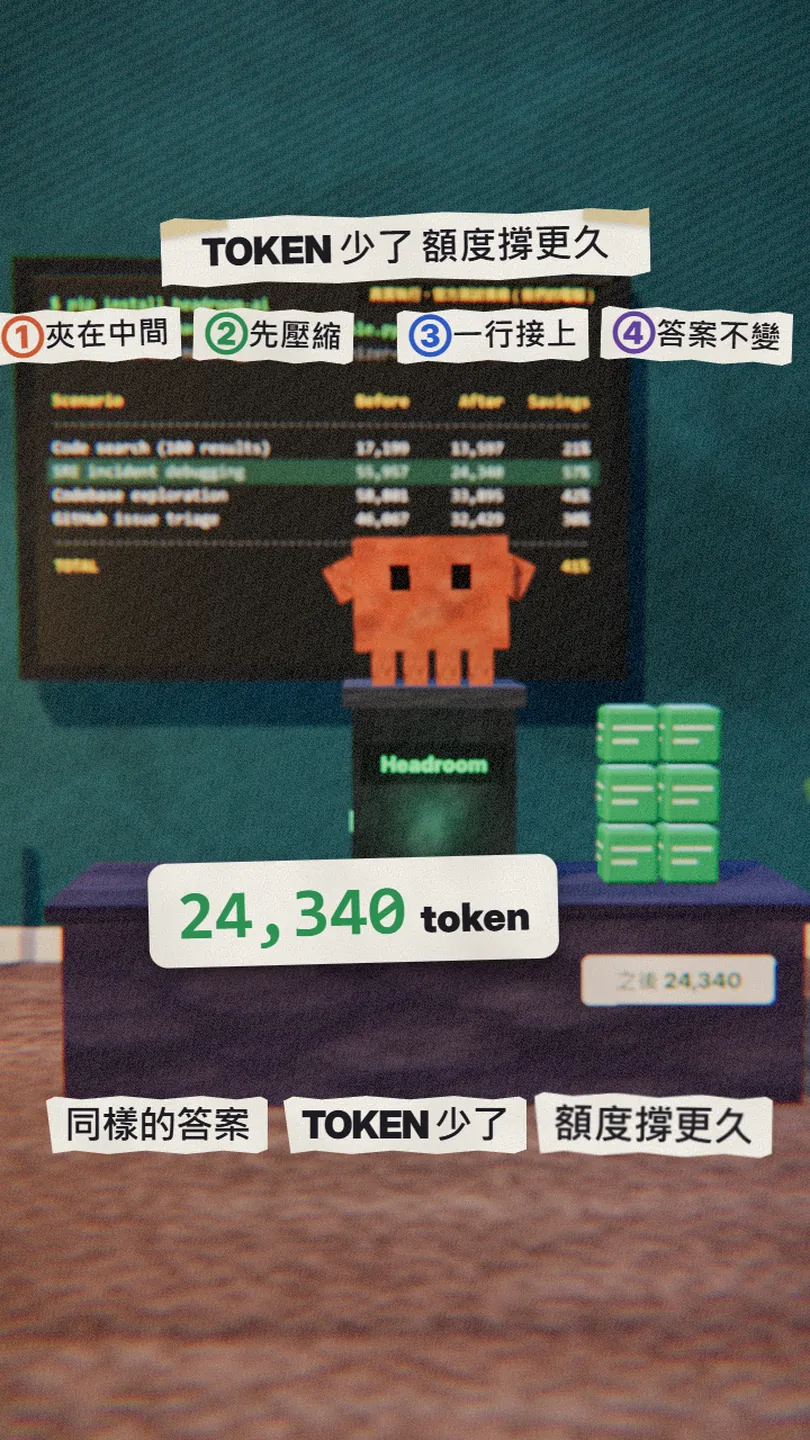
01先看結果:同一個除錯任務,token 從 55,957 變 24,340
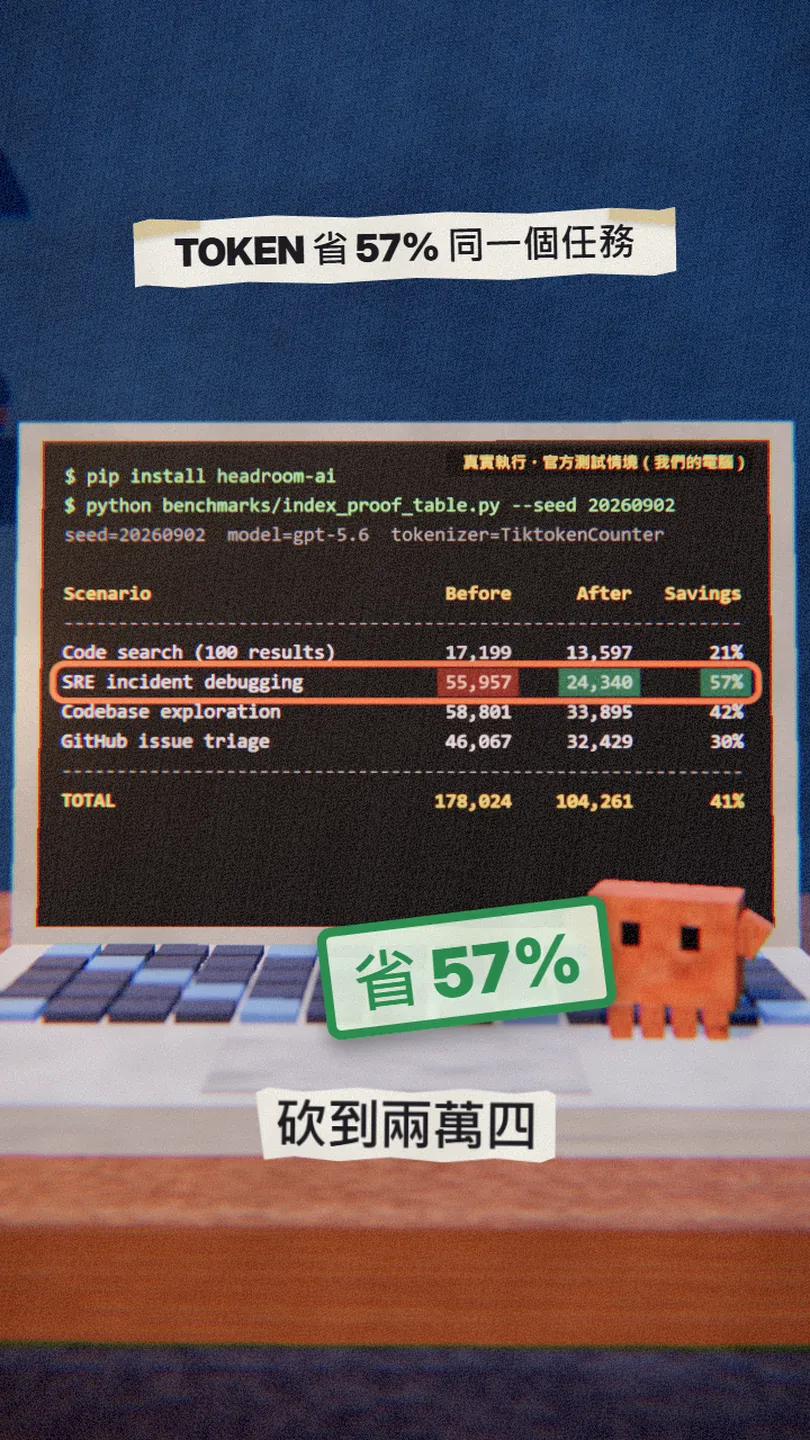
照著做完,你會得到這些:
- Claude Code 照常用,但它讀的工具輸出(log、搜尋結果、JSON)會先在你自己的電腦上壓縮,再送給模型。
- 重複的內容被壓掉,錯誤訊息這類重要的行會留著。
- 一行指令就能看到這一輪省了多少 token。
- 讀得少,同樣的額度就用得比較久。
02第 1 步:安裝 Headroom
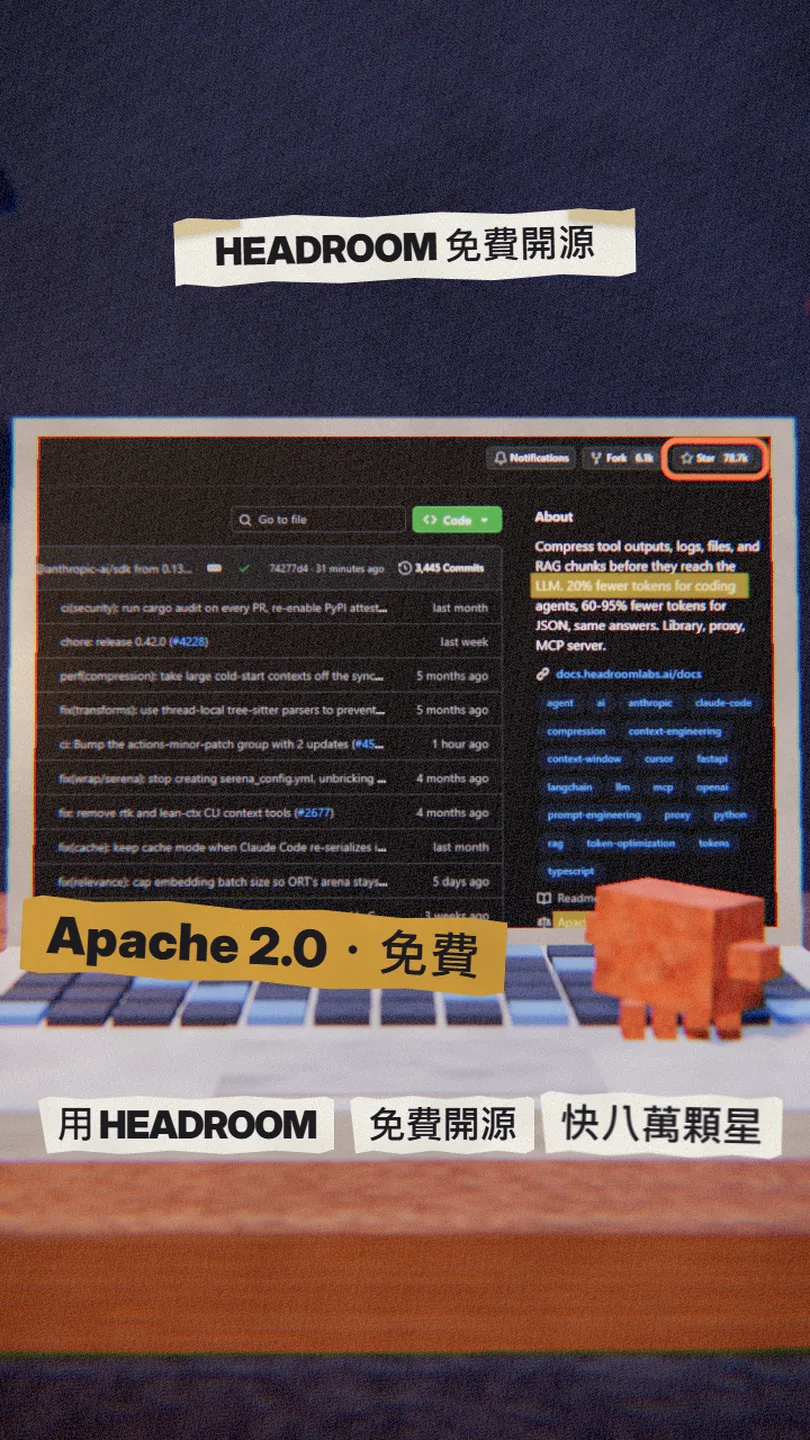
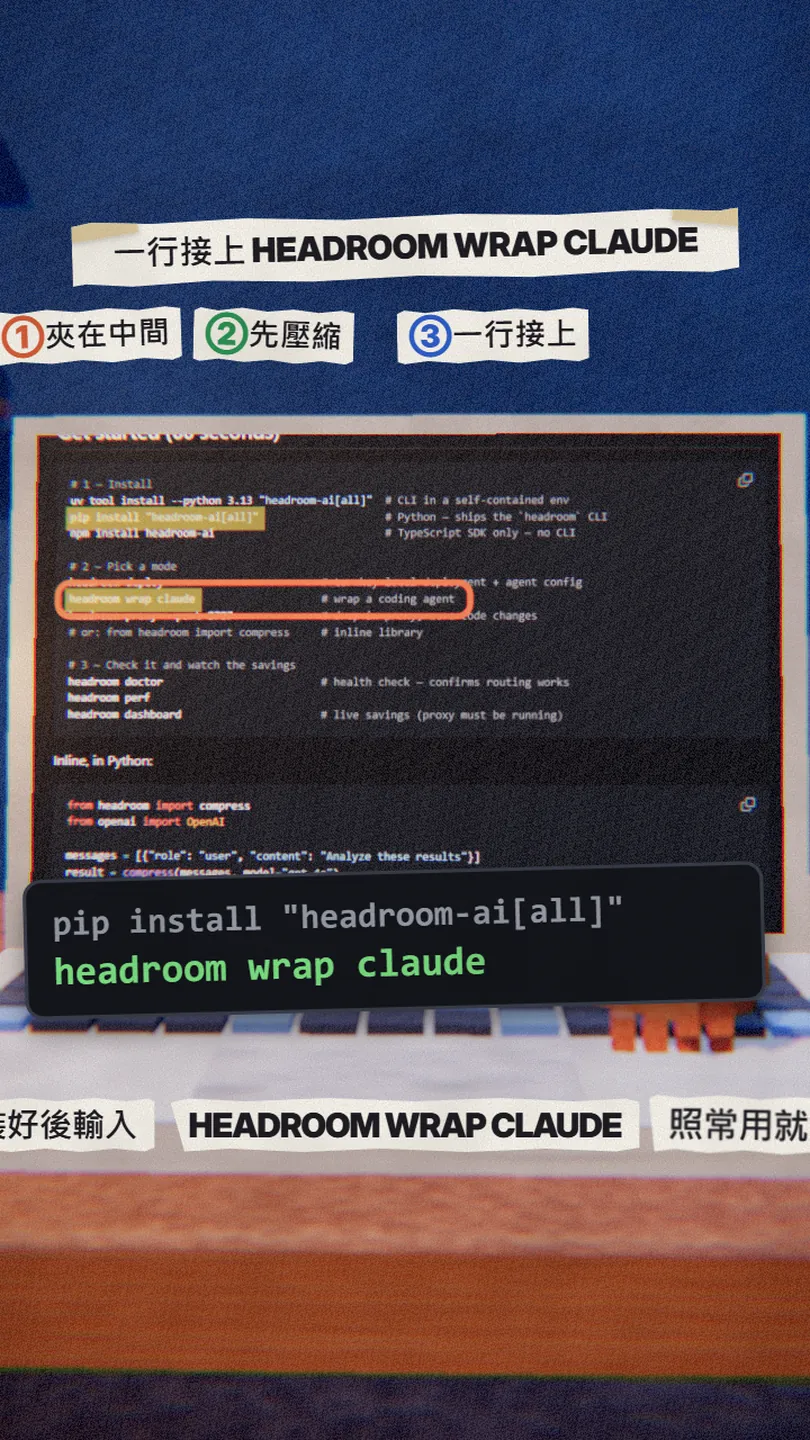
Headroom 是 headroomlabs-ai 做的開源專案,需要 Python 3.11 以上。開啟終端機,選一種裝法:
pip install "headroom-ai[all]"
uv tool install --python 3.13 "headroom-ai[all]"
裝好之後先做一次健康檢查:
headroom doctor
03第 2 步:用 headroom wrap claude 開 Claude Code
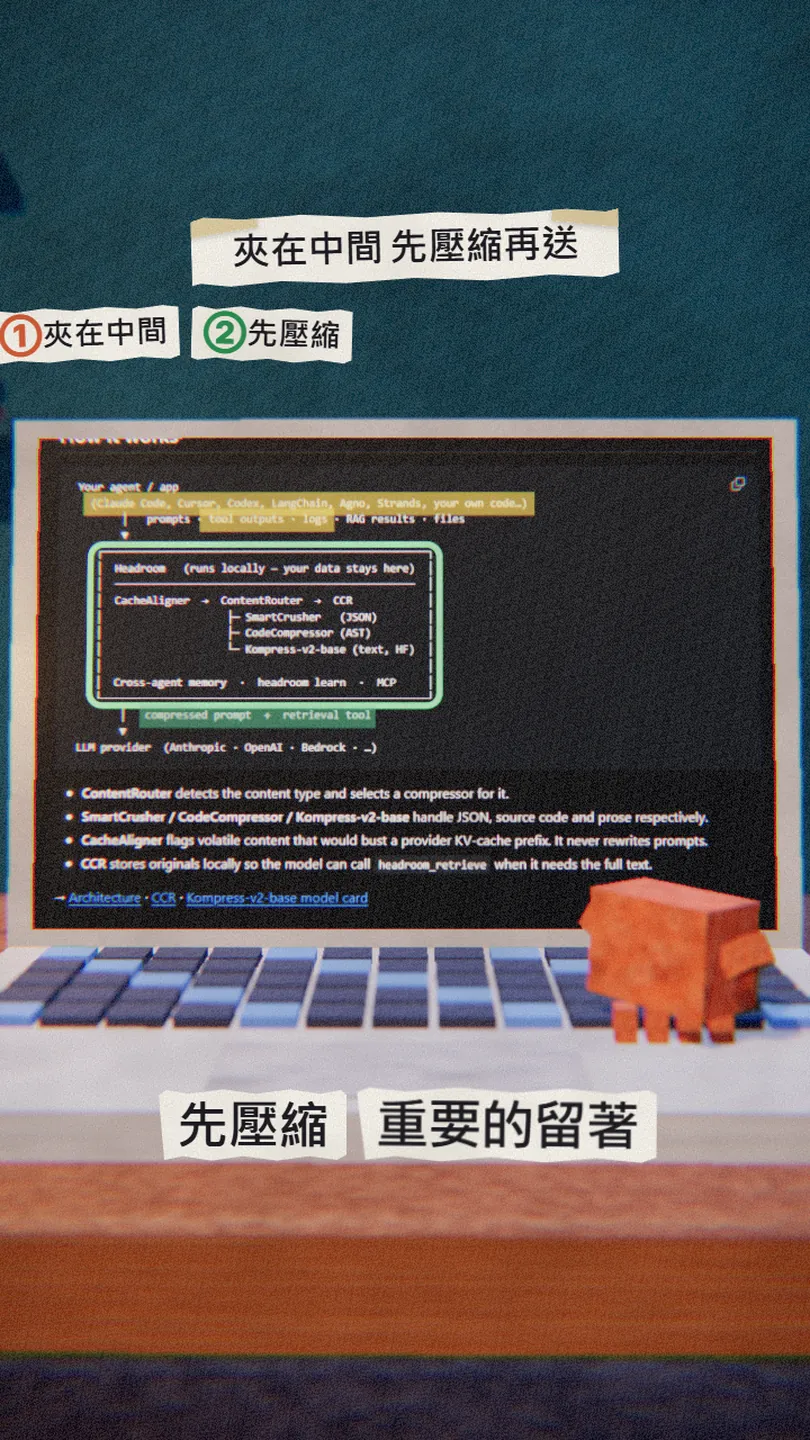
以後要用 Claude Code 時,改用這一行開:
headroom wrap claude
這行指令會做三件事:
- 在你的電腦上開一個本機代理(proxy)。
- 幫這個專案裝上 Serena(一個看程式碼結構的 MCP 工具),只裝在這個專案。
- 用這個代理啟動 Claude Code。之後照常打字就好,送出去的東西會先經過 Headroom 壓縮。
不想裝 Serena,或想手動接:
headroom wrap claude --code-memory none
headroom proxy --port 8787
ANTHROPIC_BASE_URL=http://localhost:8787 claude
04第 3 步:看省了多少,用在對的工作上
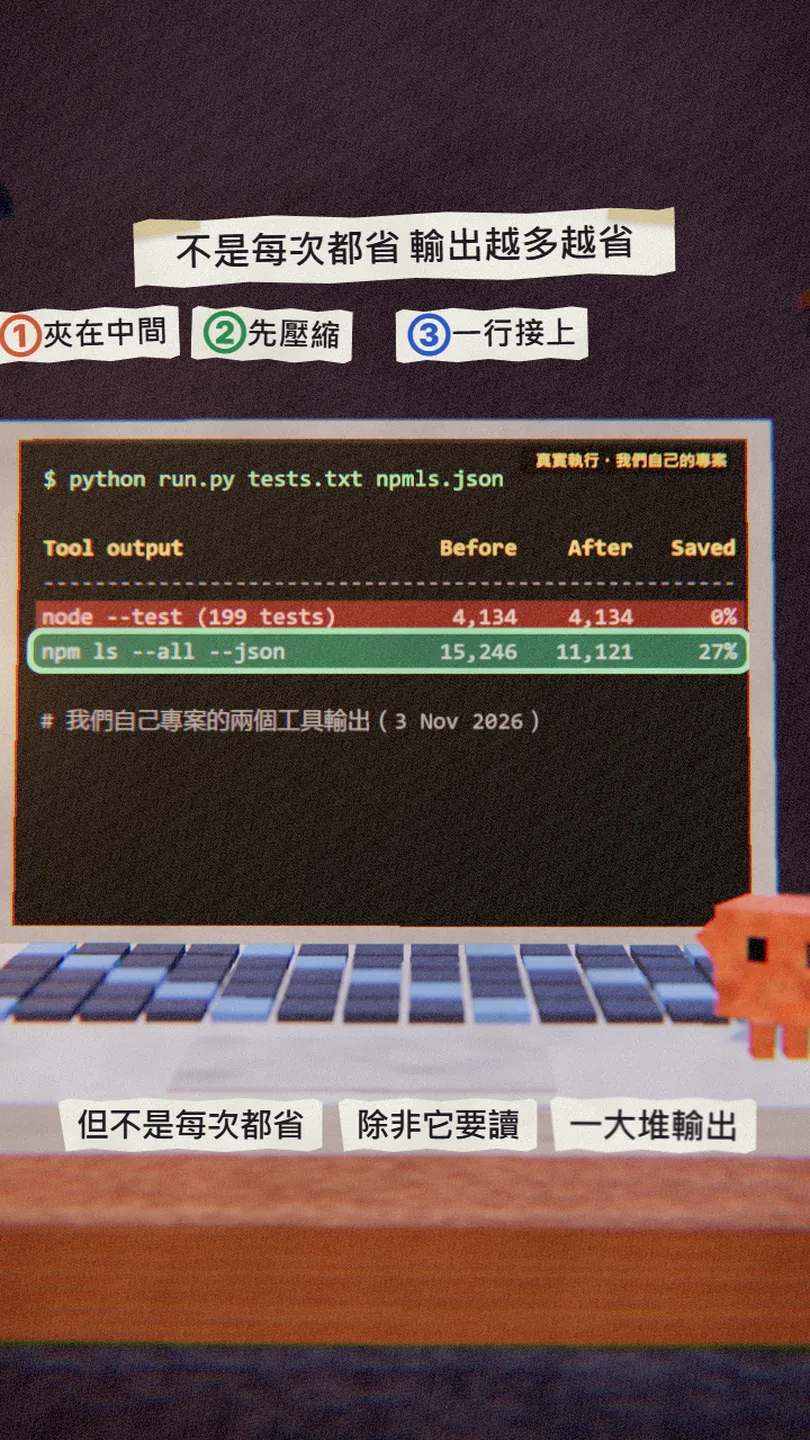
開著 headroom wrap claude 的時候,另開一個終端機看即時節省:
headroom dashboard
Headroom 最有感的是 Claude Code 要讀一大堆輸出的時候:
- 很長、很重複的 log 和建置、測試輸出。
- API 回傳的 JSON、資料庫查詢結果、幾百筆的搜尋結果。
- 工具用很多次的長對話,輸出一直累積。
這種工作可以直接叫 Claude Code 去讀,讓 Headroom 幫你壓:
幫我讀[log 檔或指令,例如:logs/server.log],找出第一個錯誤、它發生的原因,和最可能的修法。
05答案會不會變差?
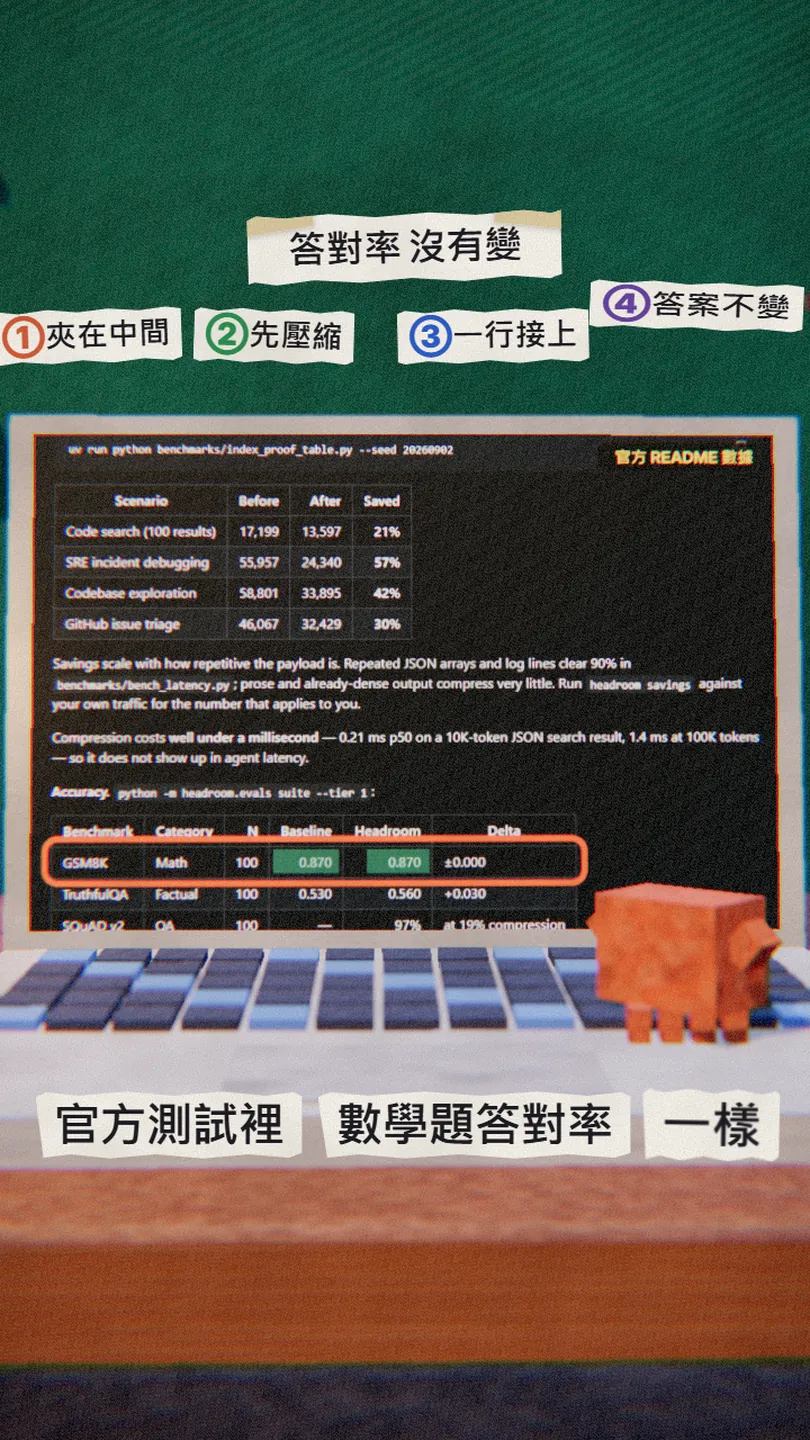
Headroom 的 README 有一張準確度表:GSM8K 數學題 100 題,不用是 0.870,用了也是 0.870;TruthfulQA 從 0.530 到 0.560,官方自己說這個差距在誤差範圍內,算沒有差別。被壓掉的原文會先存在你的電腦上,模型需要時可以呼叫 headroom_retrieve 拿回完整內容。
06要注意
- 不是每次都省:短的輸出、純文字、程式碼大多原封不動送出,省最多的是重複的 log 和 JSON。
- 它預設會送匿名統計(壓縮比例、模型名稱、作業系統,不含你的提示或程式碼);不想要就設環境變數 HEADROOM_TELEMETRY=off。
- Claude Code 走 Headroom 的時候,Remote Control 用不了;需要時就直接開 claude,不要經過它。
- headroom wrap claude 會幫專案裝 Serena;不想要就加 --code-memory none。不用了就輸入 headroom unwrap claude 還原。
- README 裡有付費的 Headroom Enterprise(給團隊),個人用開源版就好,原始碼都在 GitHub 上。
- 這篇是在主頁連結輸入關鍵字 SAVE 找到的,不會私訊。
資料來源
下一支 Reel 想學什麼?
我每天測 Claude 和 AI 工具,把真的有用的做成 Reel。追蹤 @vivianlin.tech,新教學一出來就看得到。


