~/教學/BITES.md
token 是什麼?Claude 把你的字切成一口一口:新模型約多切三成,兩招省下來
token 就是 Claude 讀字的「一口」。Claude 4.7 之後的模型,同一段文字約多 30% token。這篇講它怎麼佔記憶、怎麼算錢,還有兩個馬上能用的省法。
Claude 不是照「字」在讀你的訊息,它會先把文字切成一口一口,這一口就叫 token。額度、記憶、API 帳單,算的都是這個。這篇是 Reels 裡 BITES 那支影片的完整版:我用一個三明治把 token 講清楚,再帶你看 Anthropic 官方文件寫的三件事(新模型同一段文字大約多三成 token、token 會佔記憶、API 上輸出比輸入貴 5 倍),最後是兩個今天就能用的省法,和可以直接複製的句子。
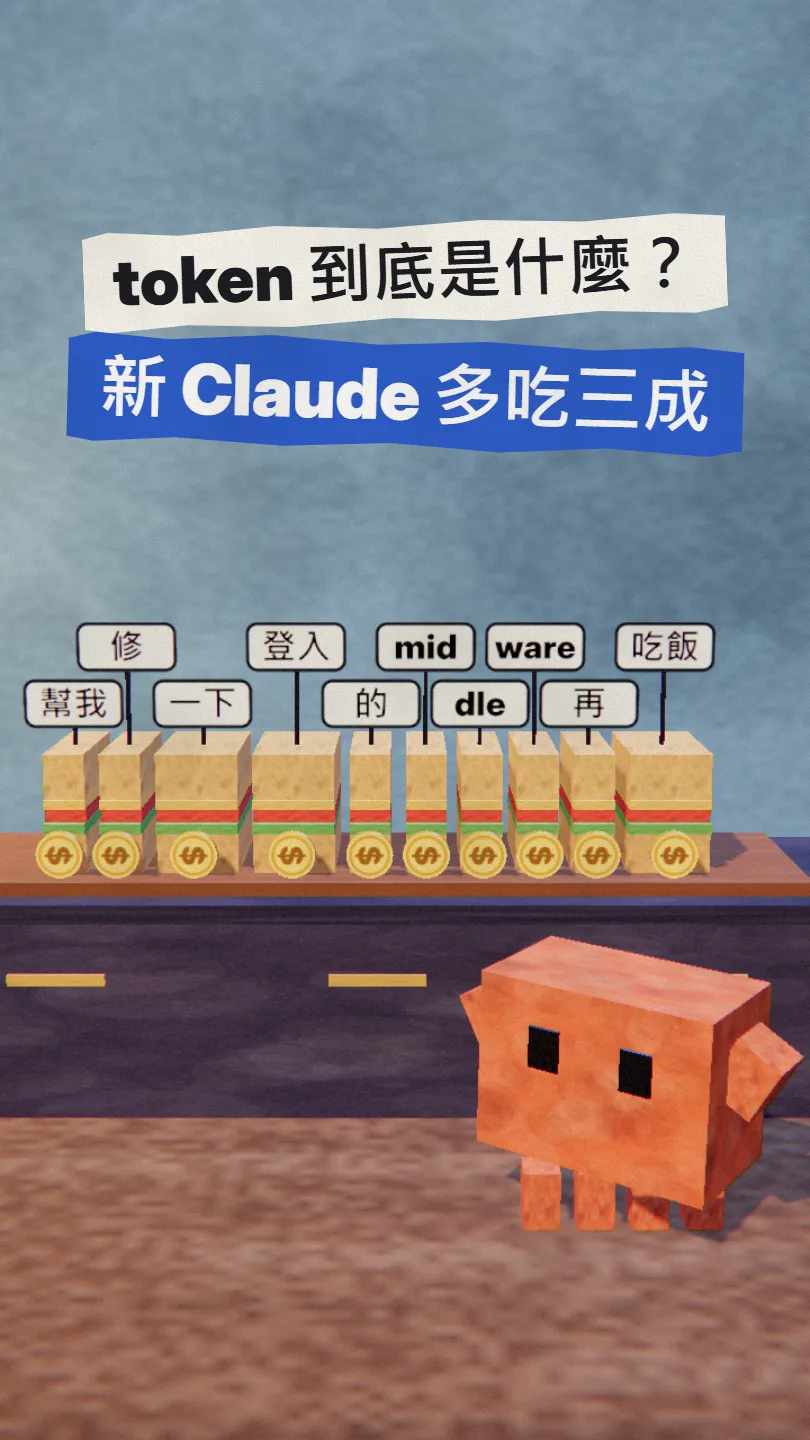
01先看結果:一句話,在 Claude 眼裡是 10 口
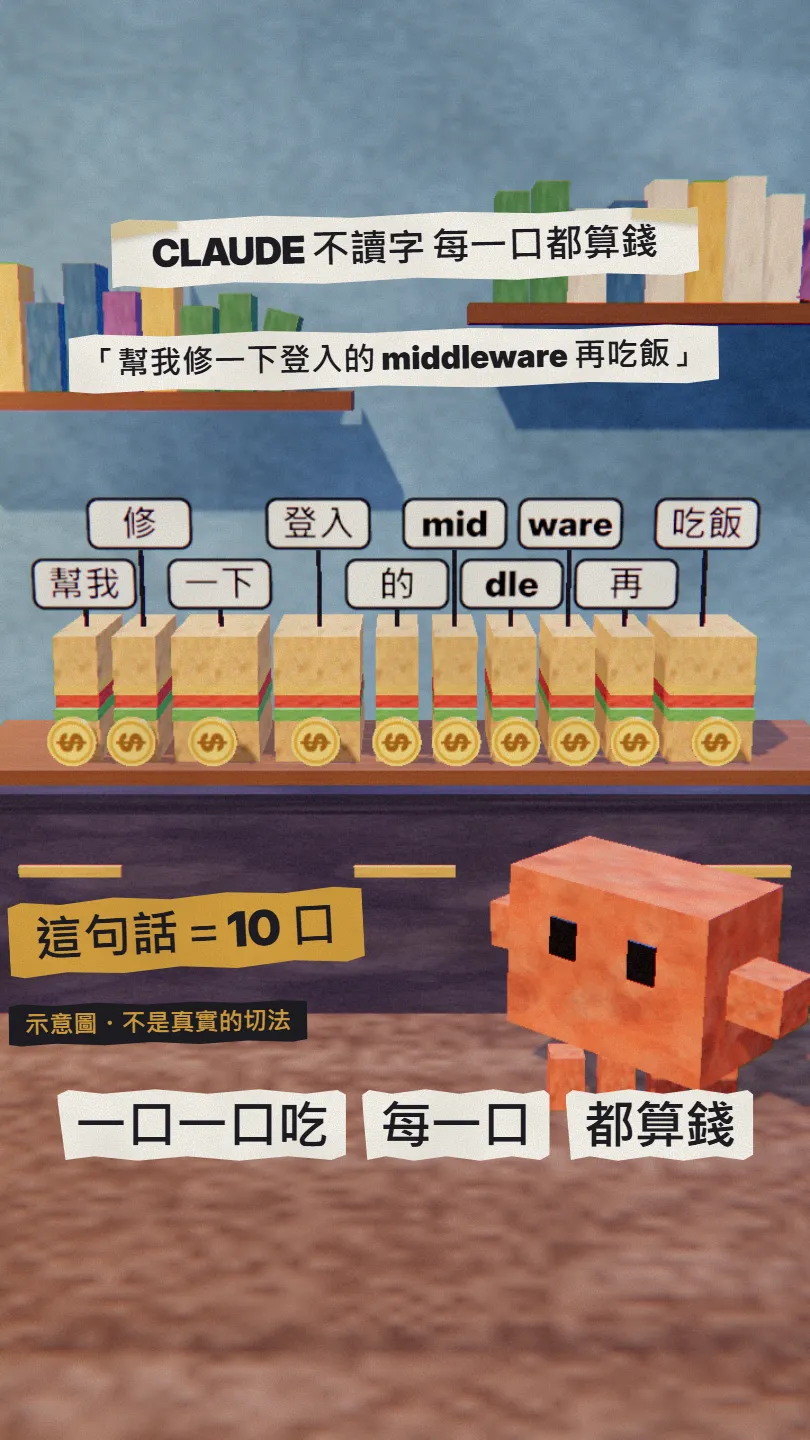
把你打的一句話想成一條三明治。Claude 沒辦法一口吞下去,所以先切成小塊再吃,每一塊就是一個 token。看完這篇,你會有:
- 一個不用背定義的說法:token = Claude 讀字的一口。
- 三個官方文件上的事實:新模型約多三成、token 佔記憶、API 輸出是輸入的 5 倍價。
- 兩個省法:換話題就開新對話、請它回答短一點,附可以直接貼上的句子。
- 一個確認方法:送出前,用官方的 token counting 先算一次。
02token 是什麼:短的字一口,長的字好幾口
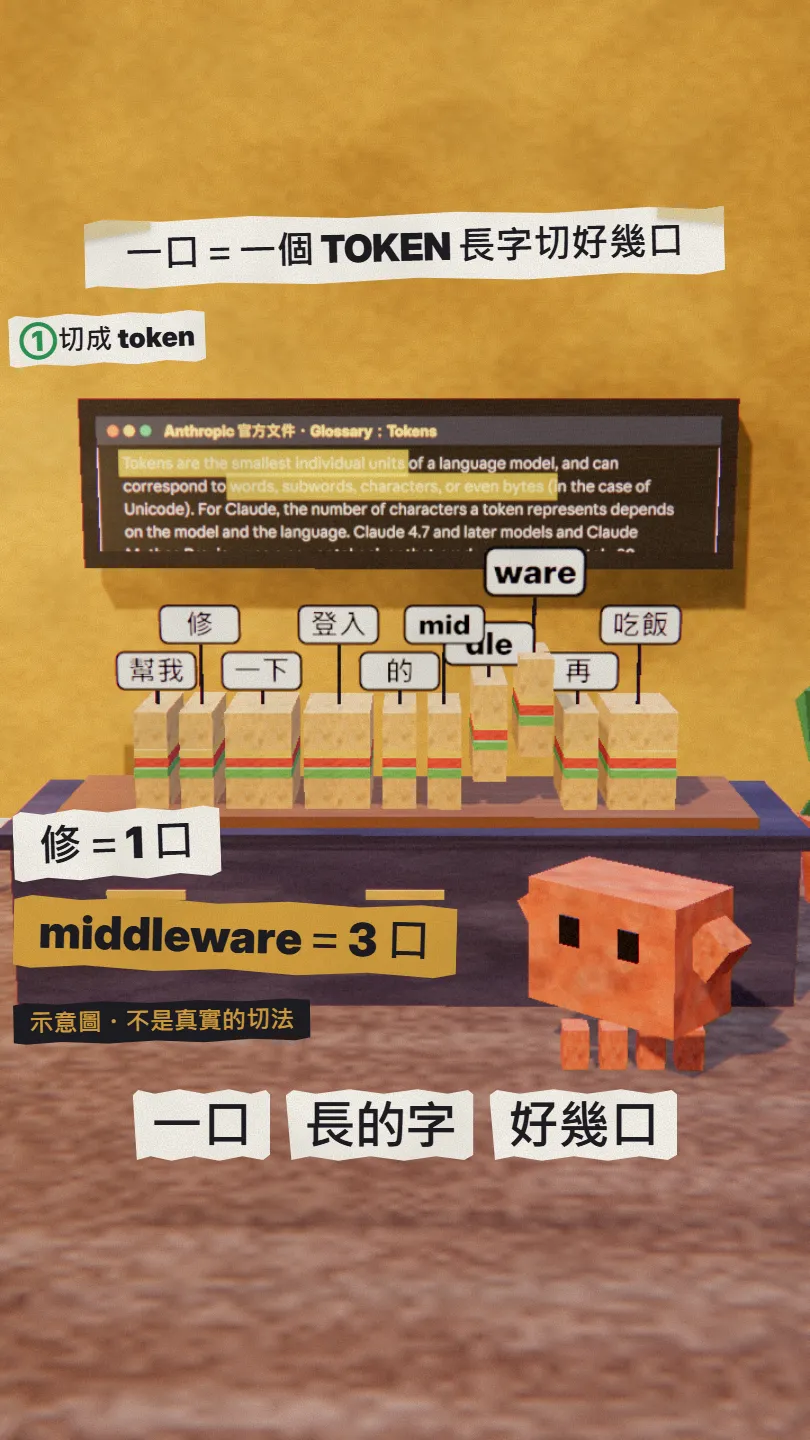
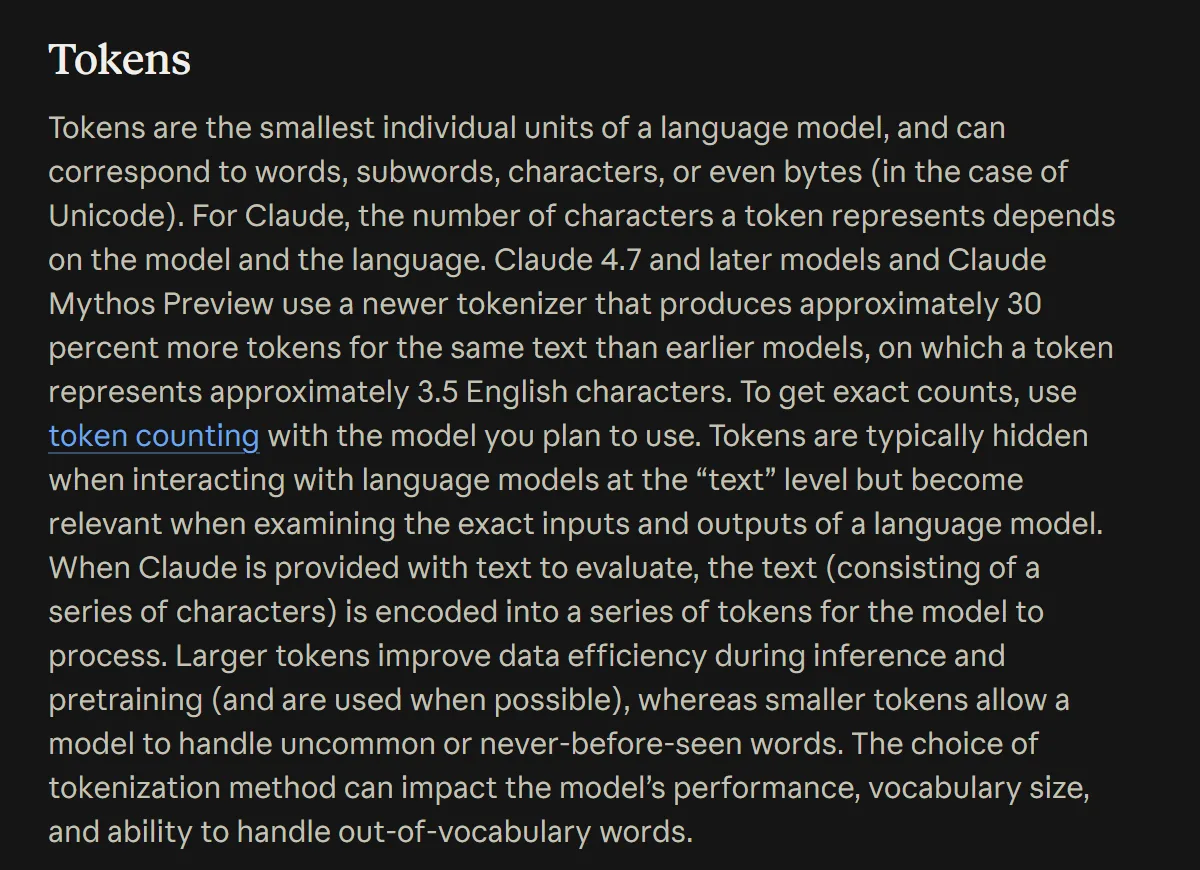
Anthropic 的官方名詞表這樣寫:token 是語言模型最小的單位,可以對應到一個字、半個字、一個字元,甚至是位元組。一個 token 代表幾個字元,要看模型,也要看語言。
- 常見的短字,通常一個 token 就夠。
- 少見或很長的字(像 middleware)會被拆成幾段,每段一個 token。
- 文件給的參考值是:在比較早的模型上,一個 token 大約是 3.5 個英文字元。這是英文的數字,中文不適用。
- 中文沒有官方的換算數字,因為「要看模型和語言」。想知道確切幾個,就用後面的 token counting。
03為什麼新的 Claude 用得比較多:同一句話,約多切三成
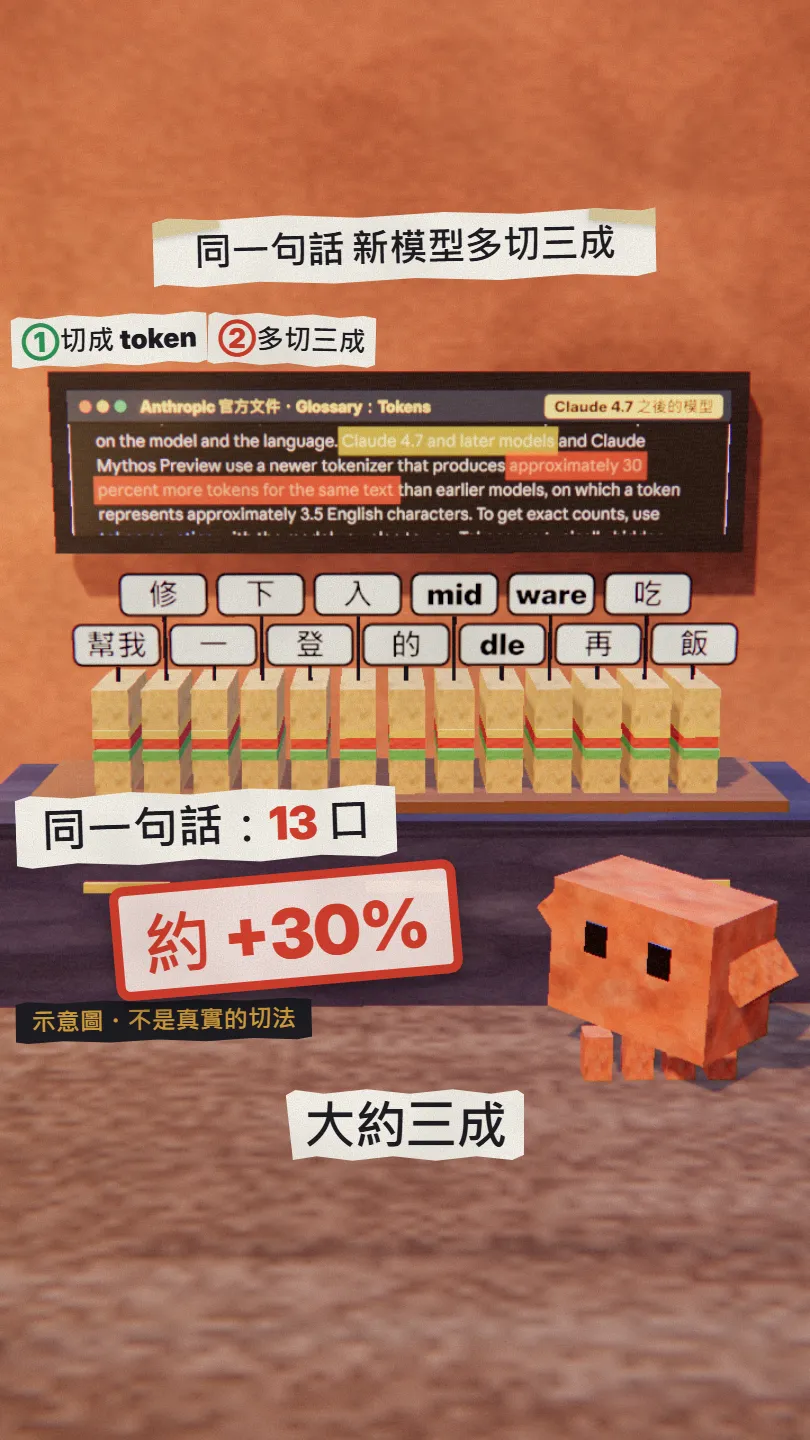
名詞表寫得很直接:Claude 4.7 之後的模型(還有 Claude Mythos Preview)用的是新的 tokenizer,同一段文字,會比之前的模型多出大約 30% 的 token。字沒有變多,是切得比較細。
- 哪些模型:官方寫的是「Claude 4.7 and later models」。token counting 那一頁也寫,Claude Fable 5.1、Mythos 5.1、Fable 5、Mythos 5 用的是 Claude Opus 4.7 開始的那個 tokenizer。
- 多多少:官方用的字是「大約」30%,而且說實際增加多少要看內容和使用方式。
- 影響什麼:同樣的訊息,在新模型上算起來比較多 token,佔的記憶和 API 費用都跟著變。
- 官方建議:換模型之後不要沿用舊模型量到的 token 數,用你要用的那個模型重新算一次。
04每一口都佔記憶,用 API 還要算錢
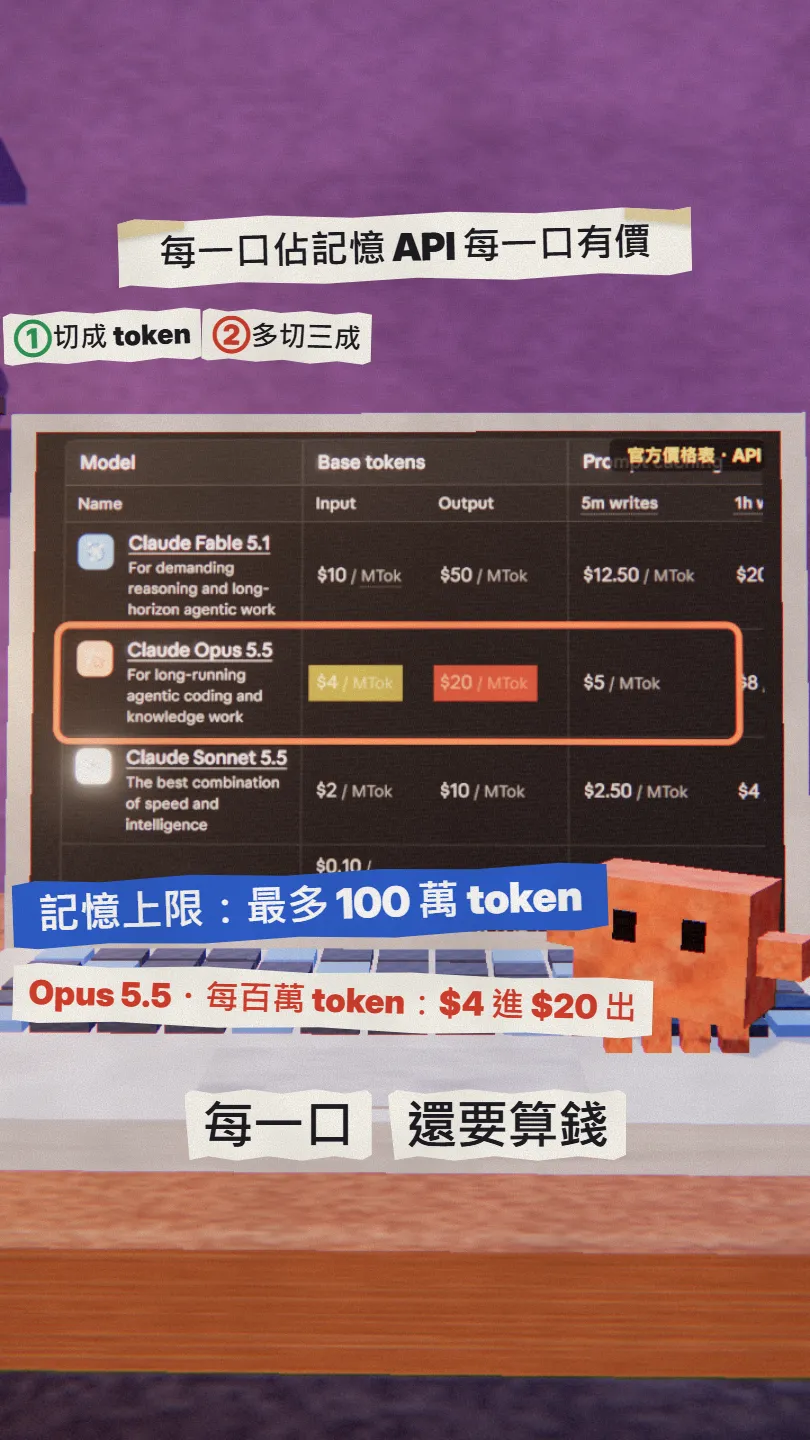
token 有兩個地方會讓你有感。第一個是記憶:Claude 一次能看的範圍叫 context window,官方名詞表把它形容成模型的「工作記憶」,上限是用 token 算的,最多 100 萬個,看你用哪個模型。第二個是錢:用 API 的話,計價單位就是 token。
- 記憶:你傳的訊息、Claude 的回答、附的檔案和工具結果,全部都算進 context window。
- API 價格(每百萬 token,2026-11-09 的官方價格表):Claude Opus 5.5 輸入 $4、輸出 $20;Claude Sonnet 5.5 輸入 $2、輸出 $10;Claude Fable 5.1 輸入 $10、輸出 $50。
- 看得出來:每一個模型,輸出的單價都是輸入的 5 倍。
- 用 Claude 的訂閱方案(Pro、Max)不是照 token 收費。但官方說明寫,訊息長度、附件大小、目前這段對話的長度,都會影響你的用量上限。
05第一招:換話題,就開新對話
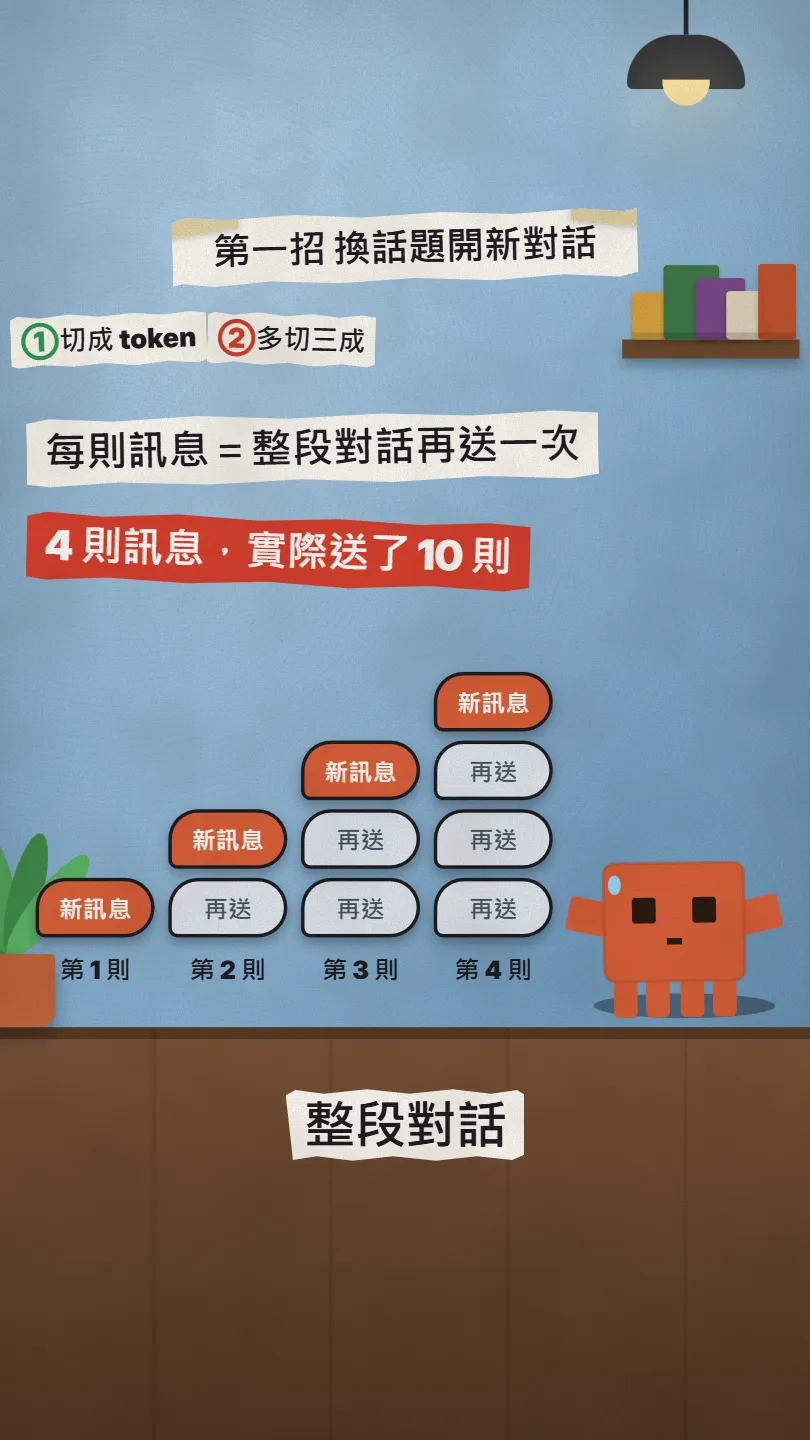
Claude 的官方文件寫,每一輪的輸入包含「之前全部的對話紀錄,加上這一則新訊息」。也就是說,對話越長,你每問一句,後面拖著的那一大串都要再吃一次。聊到第 4 則時,前 3 則也一起送了。
- 同一個主題,留在同一個對話,Claude 才記得前面講過什麼。
- 換了主題(從改履歷跳到問程式),就開一個新對話,不要讓舊的內容跟著跑。
- 舊對話裡有需要帶走的東西,先請 Claude 整理成重點,再貼到新對話。
我要開一個新對話繼續做[這件事]。
請把我們到目前為止的結論、已經決定的事、還沒解決的問題,整理成最多 8 點的清單,讓我可以直接貼到新對話。不要重貼原文。
06第二招:請它回答短一點
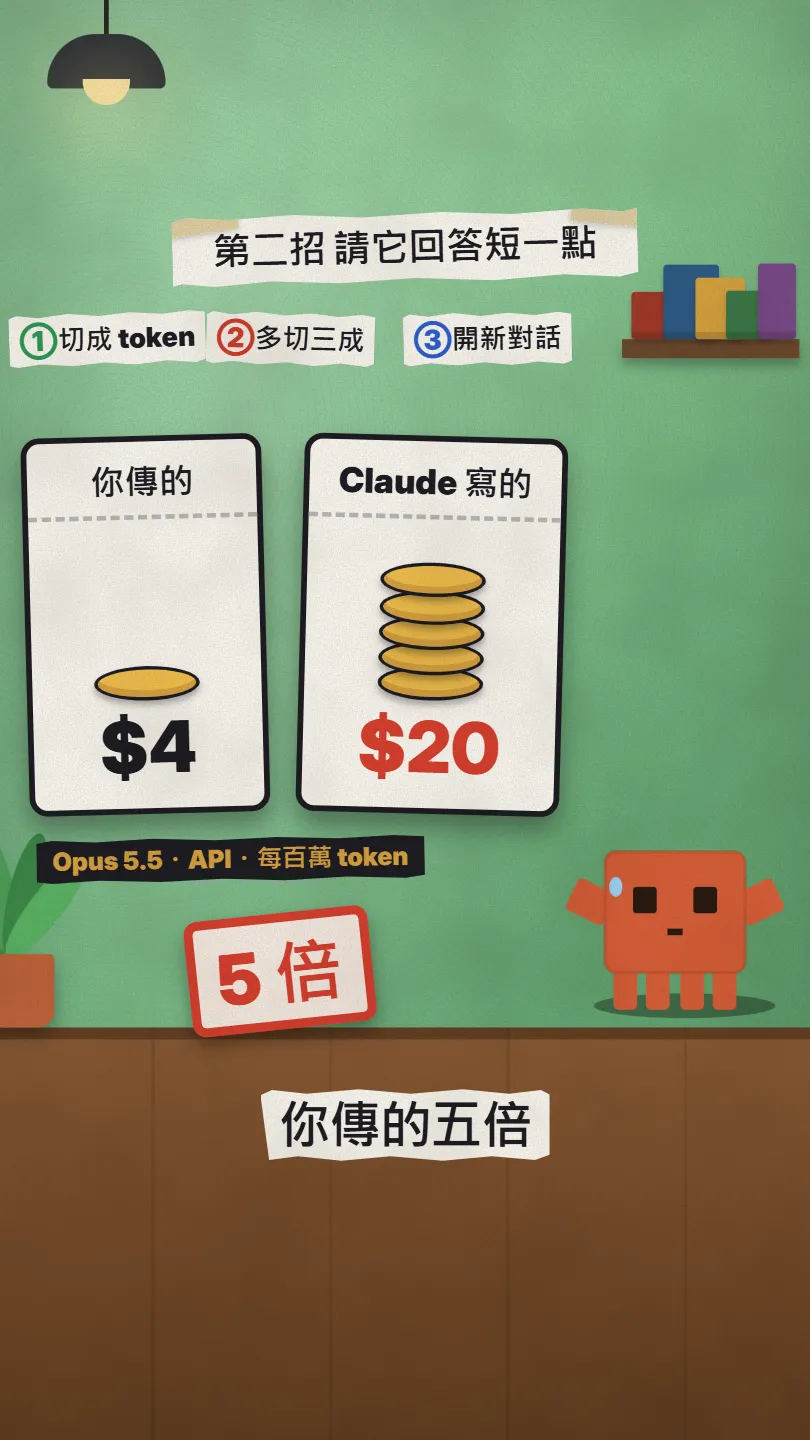
既然輸出比輸入貴 5 倍,最划算的省法就是讓 Claude 少寫一點。你不用把問題縮短,只要在問題後面多加一句,告訴它你要多短的答案。
用 3 點回答,不要開場白。
只給我有改到的那幾段,不要把整份重貼一次。改了什麼,用一句話說明。
[你的問題]
先用兩句話給我結論。我說「展開」你再寫細節。
07想知道確切幾個 token:先算再送
如果你用 API,Anthropic 有一個官方的 token counting 功能:把你要送的內容先丟給它,它會回你這次輸入大約是幾個 token。官方文件寫這個功能是免費的(有每分鐘次數上限),算出來的是估計值,實際可能差一點點。
curl https://api.anthropic.com/v1/messages/count_tokens \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "content-type: application/json" \
  -H "anthropic-version: 2026-10-21" \
  -d '{
    "model": "claude-opus-5-5",
    "system": "You are a scientist",
    "messages": [{
      "role": "user",
      "content": "Hello, Claude"
    }]
  }'
08要注意
- 三明治的切法是示意圖,10 口變 13 口也是為了畫出「約三成」。真實的 token 數請用 token counting 算。
- 「大約 30%」是官方的說法,實際會隨內容不同;3.5 個字元是舊模型上英文的參考值,中文沒有官方數字。
- 5 倍、$4 和 $20 講的是 API 的單價(2026-11-09 的價格表,價格可能會調整)。Pro、Max 訂閱不是照 token 收費,但訊息和對話越長,用量上限消耗越快。
- 「4 則訊息實際送了 10 則」只算了你傳的訊息。實際上 Claude 的回答也在對話紀錄裡,也會一起再送,所以真實情況只會更多。
- 官方文件也提到,像 claude.ai 這類聊天介面,對話太長時可能用「先進先出」的方式處理 context window,所以很長的對話,最前面的內容不一定還在。
- 回答短不等於回答好。需要完整推理或完整程式碼的時候,就讓它寫完整,省 token 不要省到答案不能用。
資料來源
下一支 Reel 想學什麼?
我每天測 Claude 和 AI 工具,把真的有用的做成 Reel。追蹤 @vivianlin.tech,新教學一出來就看得到。